大模型一旦从试点进入生产环境,提示注入、越狱攻击、敏感数据外泄就成了绕不开的三类风险。本文给出"入口拦截—过程管控—出口审计"三道防线的建设思路、能力清单与实施路径,帮你在用好 AI 的同时守住安全底线。
大模型应用安全防护
一、为什么"能用了"之后,风险反而变大了
很多单位的大模型项目都从一个试点场景开始——内部知识问答、公文辅助撰写、客服坐席辅助。试点阶段参与人少、数据范围窄,大家关心的是"答得准不准"。一旦进入生产环境,三个变化会让风险迅速放大:
- 入口变多了。 从几个人用一个对话框,变成几百上千人通过 OA、门户、业务系统、移动端接入。
- 数据变深了。 为了让模型答得准,往往要把制度文件、合同、图纸、客户资料喂进知识库——而这些恰恰是最敏感的数据。
- 权限变复杂了。 模型本身分不清"谁能看什么",一次提问就可能绕过原有的权限体系,把不该给的内容输出给不该看的人。
于是安全部门最常问三个问题:模型会不会被人套话?会不会把内部数据带出去?出了事,能不能查到是谁、什么时候、问了什么?
二、风险到底有哪些
国际上已有相对成熟的风险分类可以参照(OWASP《大语言模型应用十大风险》)。落到国内政企的实际场景,风险主要集中在这几类:
- 提示注入(Prompt Injection)——在用户输入、上传文档或网页内容里埋入隐藏指令,让模型忽略原有规则。
- 越狱攻击(Jailbreak)——用角色扮演、分步诱导、编码变形等方式绕过内容安全策略。
- 敏感数据泄露——模型把知识库中的敏感信息、或上一位用户的对话内容输出出来。
- 不安全的输出处理——模型输出的内容被下游系统直接执行,形成二次风险。
- 过度授权(Excessive Agency)——给了模型过大的操作权限,例如自动发邮件、自动改数据、自动下单。
- 供应链风险——模型、插件、第三方组件来源不可控。
- 内容合规风险——生成违法违规、涉密涉敏、侵权内容。
- 成本与可用性风险——被恶意高频调用,算力被占满,正常业务受影响。
三、建设思路:按数据流摆三道防线
不建议一上来就采购设备,而是先按"数据流"把防线摆清楚。一次大模型调用,数据只经过三个位置:进去之前、模型里、出来之后。对应三道防线:
第一道·入口拦截。 在用户与大模型之间部署大模型防火墙(护栏),对输入做意图识别、提示注入检测、越狱特征匹配、敏感信息预检。这一层解决"不该问的别问进来"。
第二道·过程管控。 对知识库检索和工具调用做权限控制。检索必须携带用户身份,保证"用户看不到的内容,模型也检索不到";对模型可调用的工具与 API 建立白名单,高危操作要求人工审批。这一层解决"模型能拿到的,不该超出用户权限"。
第三道·出口审计。 对模型输出做二次过滤,识别敏感数据与违规内容并拦截;全量记录"谁、何时、问了什么、答了什么、命中了哪条策略",形成完整可追溯的审计链条。这一层解决"出了事查得到、追得回"。
三道防线里,第一道和第三道靠产品能力,第二道靠梳理与配置——三样缺一不可,只买设备不做权限梳理,等于装了门禁却没给每个人发不同的卡。
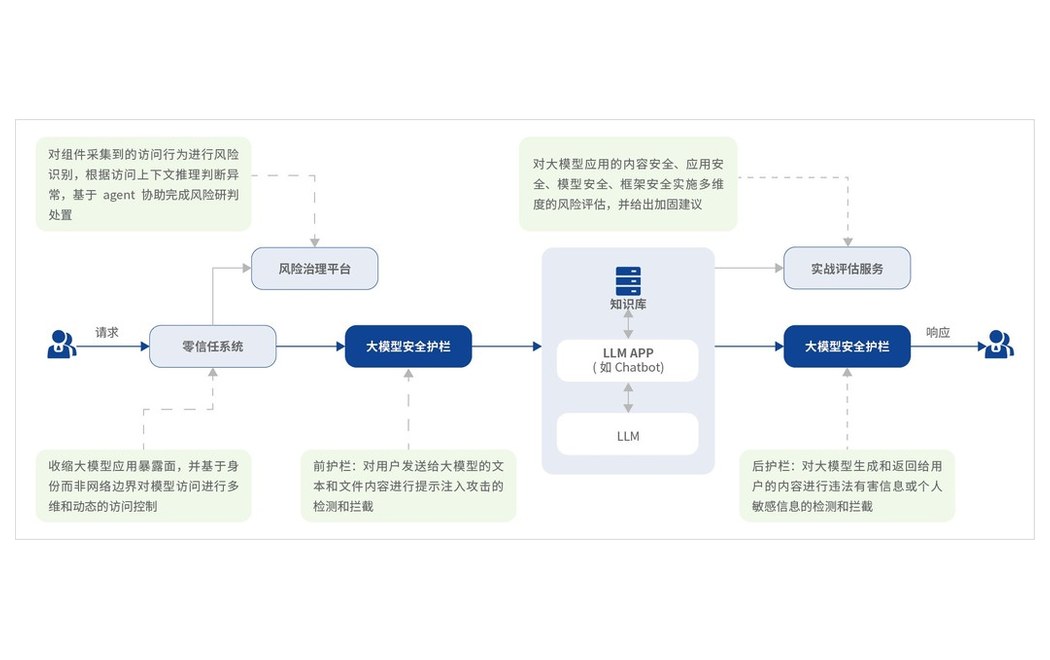
大模型安全护栏部署架构
四、需要建设的能力清单
| 能力项 | 具体内容 |
|---|---|
| 输入安全检测 | 提示注入与越狱特征库、异常提问模式识别、多轮诱导检测 |
| 敏感信息预检 | 身份证、手机号、账号口令、涉密标识等规则识别 |
| 输出内容过滤 | 敏感数据外发拦截、违规内容识别、输出格式校验 |
| 权限穿透控制 | 知识库按用户身份过滤,保证检索结果不越权 |
| 工具调用管控 | 可调用工具白名单、高危操作二次确认与审批留痕 |
| 全量会话审计 | 会话留存、策略命中记录、按人/按部门/按时间检索 |
| 策略与运营 | 策略模板、告警分级、定期策略复盘与优化 |
| 模型与内容标识 | 生成内容标识、水印,满足内容溯源要求 |
五、实施路径
- 资产与场景梳理(1~2 周)。 盘清当前有哪些大模型应用、接入方式、涉及哪些数据、开放给哪些人。
- 策略设计(1 周)。 按数据密级和用户角色设计准入策略、检索权限策略、输出过滤策略。这一步需要业务部门参与,不是纯技术活。
- 部署与联调(2~3 周)。 部署安全网关或防火墙,与现有大模型平台、知识库、统一身份认证对接,先以"观察模式"运行,只记录不拦截。
- 灰度与常态运营(持续)。 观察期结束、误拦率可控后开启拦截;建立月度策略复盘机制,把新出现的攻击样本补进特征库。
六、对客户的价值
- 让 AI 项目能过审。 政企单位推进大模型,安全合规评审是必过的一关,防线建好了,项目才推得下去。
- 把风险控制在可解释范围内。 不是"保证百分百不出事",而是每一条风险都有对应的检测项、处置动作和审计记录。
- 避免一次事故毁掉整个项目。 大模型项目最怕的不是慢,而是出一次数据泄露事故后被叫停。
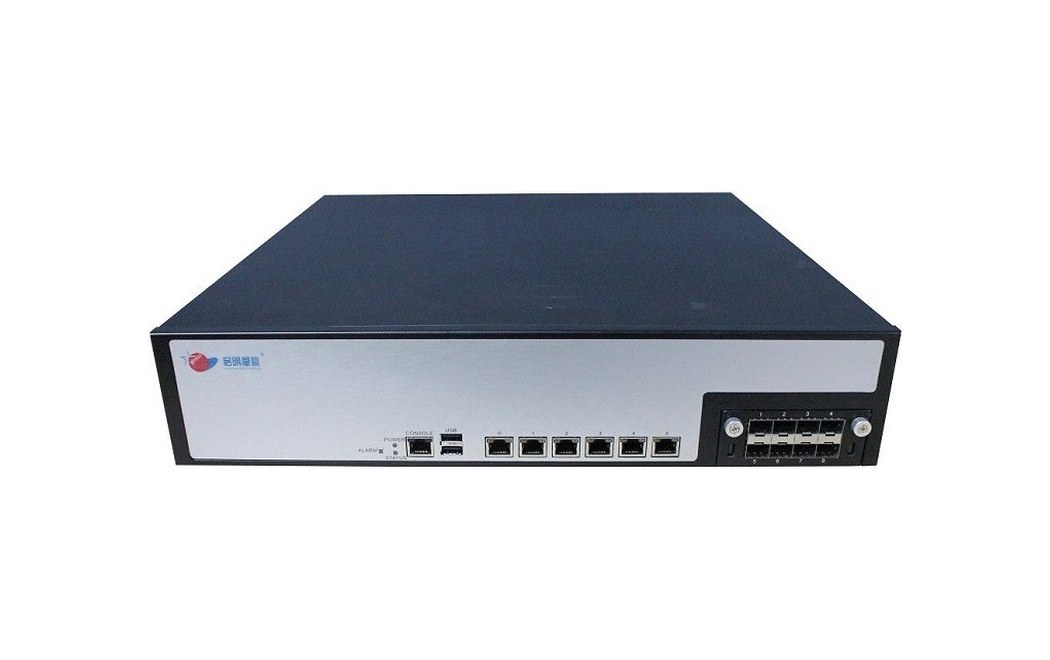
启明星辰 大模型应用防火墙(MAF)
七、推荐产品与厂商支撑
本方案以成熟安全产品为基础做集成落地,可选产品线包括:
- 启明星辰 大模型应用防火墙——输入输出双向检测、提示注入与越狱防护。
- 奇安信 大模型卫士/AI 安全网关——AI 流量识别、大模型应用安全管控。
- 安恒信息 大模型内容安全防火墙(MAF)——内容安全与合规检测。
- 深信服 安全使用 GenAI 相关方案——办公场景下的大模型安全使用管控。
配合公司已有的统一身份认证、数据防泄漏、日志审计能力,形成完整闭环。
八、为什么选择大中
大中的主业内核是信息安全,同时是启明星辰、奇安信、深信服、安恒、绿盟、天融信、360、美创的长期合作伙伴。这个方案里最难的不是装一个产品,而是把安全策略和你现有的大模型应用、知识库、身份体系真正对上——这需要既懂 AI 应用架构、又懂安全体系的人来做。公司既能做 AI 侧的集成,也能做安全侧的落地,一家交付,责任不推诿。
另需说明:AI 安全产品迭代很快,正式立项前我们会按厂商最新产品资料复核具体型号与参数,并出具针对你单位场景的选型建议。
关键词:大模型安全、提示注入防护、大模型防火墙、数据防泄漏、AI 安全治理