数据分类分级是数据安全合规的第一道关,但人工做法往往卡在"字段太多、识别不准、做不完"。本文说明 AI 分类分级的工作原理、效果区间、与脱敏及运维管控的联动方式,以及如何在有限周期内完成落地。
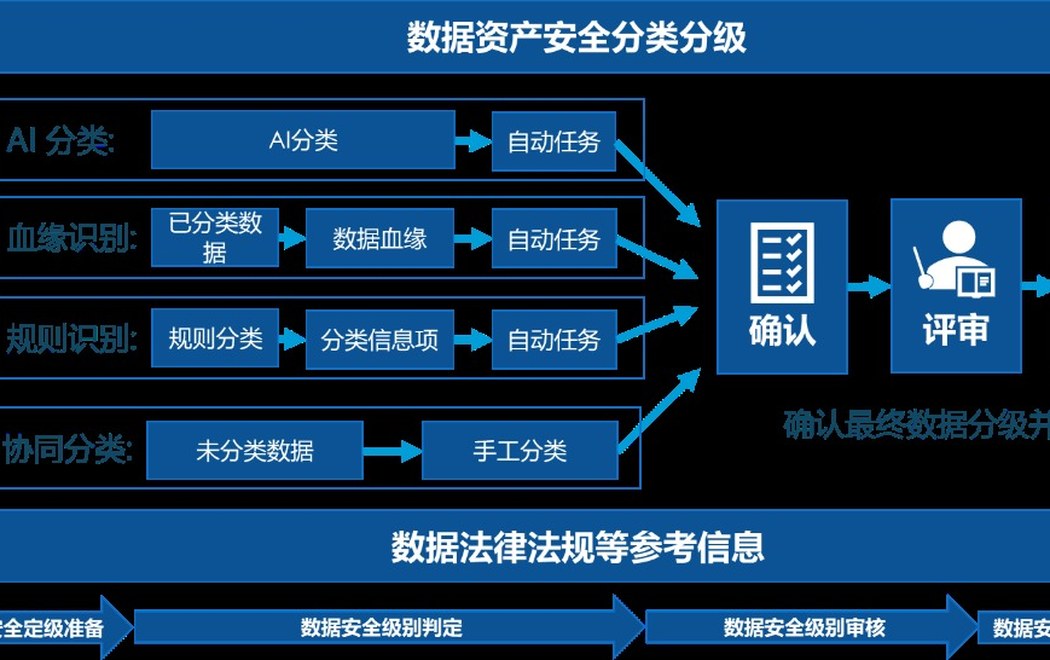
数据资产安全分类分级流程
一、为什么分类分级总是做不完
《数据安全法》《个人信息保护法》以及各行业的监管要求,都把数据分类分级列为前置工作。但真正动手做过的单位都知道这件事有多难:
- 数据量太大。 一个中等规模的业务系统,数据库表动辄上千张、字段数万级,靠人工逐个看,时间成本无法接受。
- 识别靠猜。 字段名叫
f0123、data_tmp_2这类的情况比比皆是,只能打开数据看内容,效率极低。 - 判不准。 同一个字段里既有个手机号又有备注文本,人工判断标准不统一,不同人给出不同结果。
- 做完就过期。 好不容易分完了,业务一改版、新系统一上线,分类结果又对不上了。
结果是很多单位的分类分级工作停在"表格做了一半"的状态——检查来了补一补,平时没人碰。
二、AI 在这里解决什么问题
AI(尤其是自然语言处理与内容识别模型)的价值不在"替代制度",而在批量完成"看不完、判不准"的那部分工作:
- 自动扫描与发现。 自动连库扫描,把之前没人统计过的"暗数据"找出来——往往一扫描才发现,实际的数据资产比台账上多得多。
- 按内容识别而非按字段名识别。 读数据内容判断业务类型,字段名叫什么都不影响识别结果。
- 行业模板开箱即用。 内置医疗、政务、金融、教育等行业的分类分级模板,直接套用行业标准,减少从零定义的工作量。
- 给出置信度,人工只看"拿不准的"。 高置信度结果直接采纳,低置信度结果推给人工复核,复核工作量可以降低到原先的一小部分。
从厂商公开的实践数据看,引入 AI 后,敏感数据识别率可从人工方式的约 70% 提升至 99% 以上,识别准确率可从约 50% 提升至 85% 以上。这两个数字的差别很关键——前者决定"漏不漏",后者决定"人工还要不要复核"。
三、分类分级的价值在于"联动"
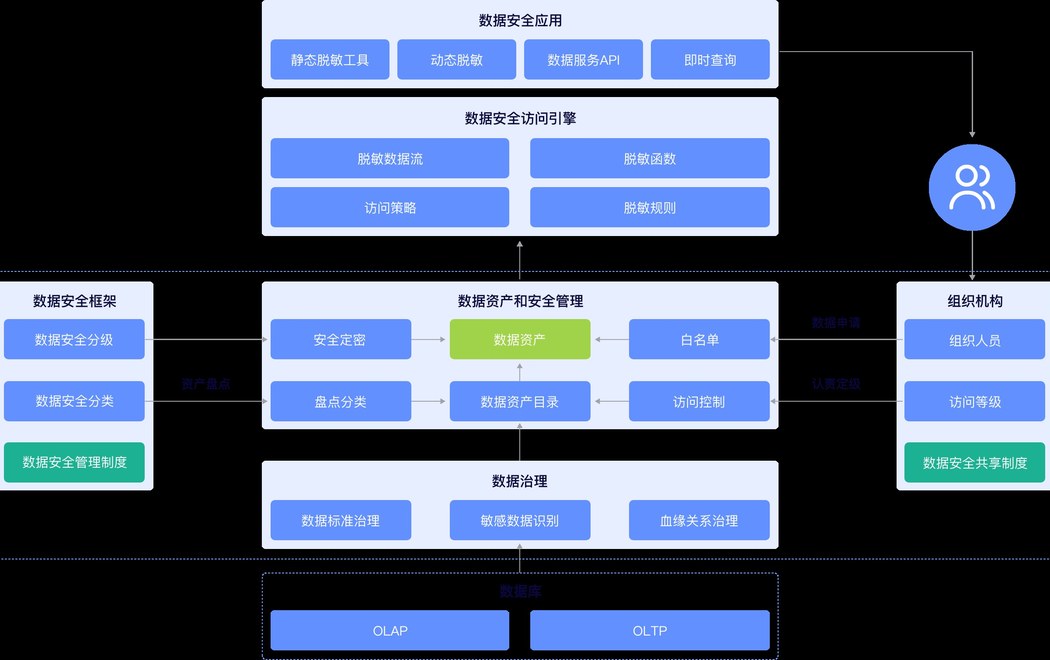
分类分级本身不产生安全效果,它是一张"地图"。真正产生效果的是把地图用起来:
- 联动脱敏:高敏感级别的数据,在非生产环境(测试、开发、分析)自动脱敏使用。
- 联动运维管控:数据库运维人员访问敏感表时,自动触发审批、录屏、语句拦截。
- 联动访问控制:按数据级别细化到字段级的访问策略。
- 联动审计:对高敏感数据的访问行为做重点审计与异常告警。
- 联动数据出境与共享:涉及数据对外提供时,按级别走不同的评估流程。
只分类不联动,等于白做。 我们在方案设计时会把联动策略一起规划,避免分类成果躺在表里睡觉。
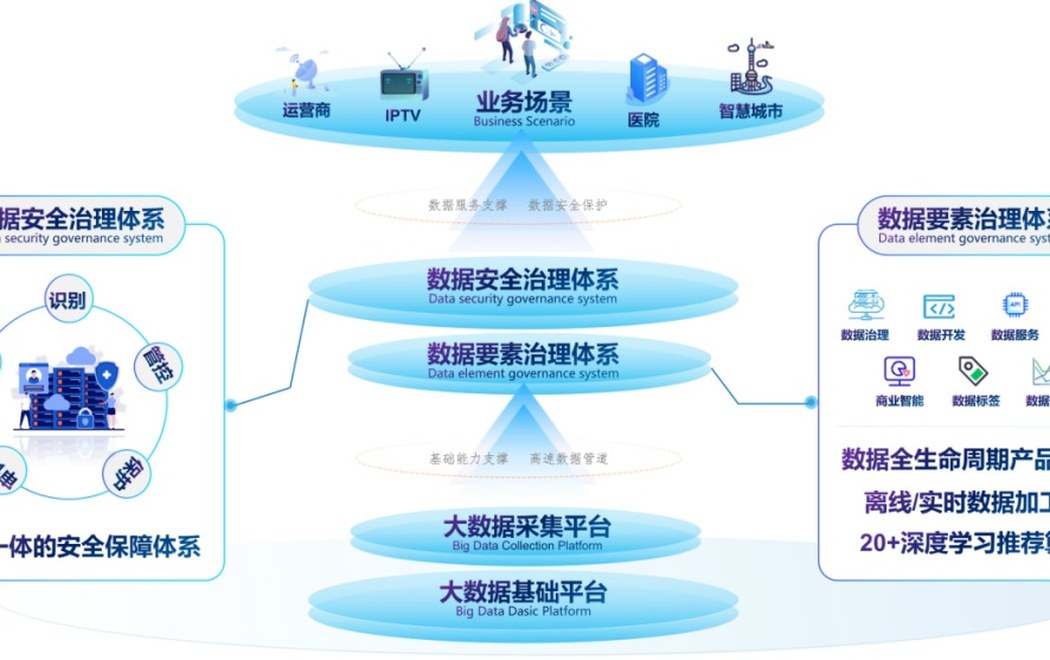
分类分级成果融入数据安全治理体系
四、实施路径
- 范围界定(1 周)。 确定第一批纳管系统(建议从最核心的 2~3 个业务系统开始,不要一上来全铺开)。
- 自动扫描与初判(2~3 周)。 完成数据资产扫描、分类分级初判,输出待复核清单。
- 人工复核与标准固化(2 周)。 业务部门复核低置信度结果,同时把判断口径固化为规则,形成本单位的分类分级标准。
- 策略联动上线(2~4 周)。 按级别配置脱敏、运维管控、审计策略。
- 持续运营。 新增系统上线时同步纳管,建议每季度做一次增量扫描。
五、客户价值
- 周期从"做不完"变成"做得完"。 把数万级字段的识别工作量压缩到人工可承受的范围。
- 过合规检查。 有分类分级成果、有复核记录、有联动策略,数据安全合规有据可依。
- 看得见数据家底。 顺带完成一次数据资产盘点,很多单位扫描后才发现数据分布与预期偏差很大。
- 为后续 AI 应用铺路。 分类分级结果是做数据治理、做知识库权限控制、做 AI 数据安全的基础。
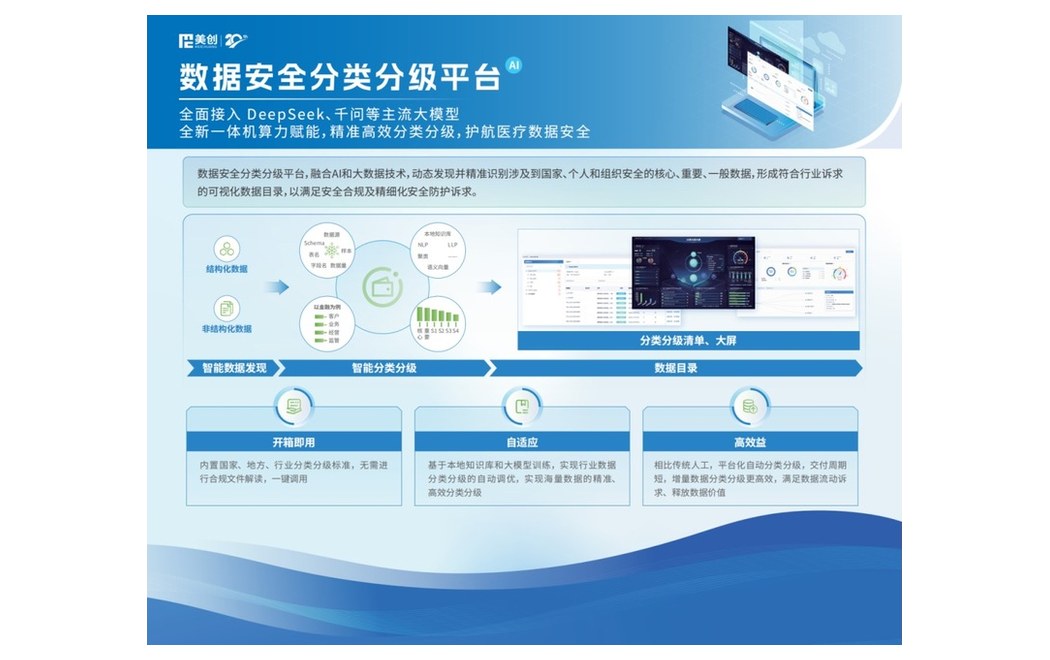
美创科技 智能数据安全分类分级平台
六、推荐产品与厂商支撑
- 美创科技(公司已代理)智能数据安全分类分级平台、暗数据发现与分类分级系统——支持 AI 模型识别、行业模板、与脱敏/运维管控联动。
- 结合公司数据安全产品线(数据库审计、运维管控、数据防泄漏)形成完整方案。
七、为什么选择大中
大中在数据安全方向已有多年交付经验,对客户现场的数据库架构、运维方式、审计要求都熟悉。分类分级项目最容易出的问题是"扫完没人复核、复核完不联动",我们会把这三件事一起纳入交付范围,并用公司已代理的美创产品降低你的采购成本与集成风险。
关键词:数据分类分级、智能脱敏、暗数据发现、数据安全治理、敏感数据识别